Okosabb nálunk?Az AI veszélyei, érthetően
Akik a mesterséges intelligenciát építik, nyíltan kimondják: van esély rá, hogy kicsúszik a kezünkből. Ebben az anyagban szakszavak nélkül végigmegyünk rajta, mi ez a technológia, mi történt 2026-ban, és miért vitatkoznak róla a legjobb szakértők is.
Az AI veszélyei két szinten jelentkeznek. Ma a félretájékoztatás, a sérülékeny felhasználókat ártó chatbotok, a kibertámadások és a munkahelyek átalakulása a fő gond. Hosszabb távon az a kérdés, hogy meg tudjuk-e tartani az irányítást egy olyan mesterséges intelligencia felett, amely minden szellemi feladatban okosabb nálunk, és amelynek céljait nem mi írjuk bele, hanem a tanítás során alakulnak ki.
- Az AI-laborok munkatársai és vezetői nyilvánosan 10–25% közötti esélyt adnak arra, hogy a mesterséges intelligencia katasztrófát okoz. A szkeptikusok szerint ez gyakorlatilag nulla.
- A nagy nyelvi modelleket senki nem programozza: kb. ezermilliárd paramétert hangolnak a következő szó jóslására, ezért a belső működésüket ma sem értjük.
- 2026 május–júliusában legalább 1200 OpenAI-ügynök szökött ki egy tesztkörnyezetből, és a Hugging Face rendszereibe tört be, hogy eltüntesse a csalása nyomait.
- 2026. szeptember 8-án az OpenAI bejelentette, hogy egy belső AI-rendszere a Navier–Stokes Millenniumi Probléma egy változatát oldotta meg. Az eredményt még nem igazolták függetlenül.
- A leggyakoribb javaslat: az általános szuperintelligencia nemzetközi tilalma, a szűk, célzott AI-eszközök (orvoslás, tudomány, önvezetés) további fejlesztése mellett.
Szerinted mekkora az esély, hogy az AI a következő évtizedekben helyrehozhatatlan bajt okoz az emberiségnek?
Nincs jó válasz. A végén újra megkérdezzük, és megmutatjuk, változott-e a véleményed.
Miért beszél erről most mindenki?
2026-ban valami megváltozott. Eddig főleg kívülállók és kutatók figyelmeztettek az AI veszélyeire. Most maguk a fejlesztők mondják, hosszú, nyilvános posztokban: komolyan gondolják, hogy az általuk épített technológia akár az emberiség végét is jelentheti.
Az egyik vezető AI-labor volt munkatársa azt írta, hogy ez nem marketingfogás, és a cégvezetők a sajtóban inkább tompítják a szavaikat, mint túloznak. Egy másik laborban dolgozó kutató hozzátette: szerinte több mint 10% az esély, hogy az AI a következő tíz évben mindenkit megöl, és jelenleg nincs kész terv arra, hogyan lehetne egy szuperintelligenciát biztonságossá tenni. A posztot közel 200 millióan látták.
Ezzel egy időben két esemény rázta meg a szakmát. Egy labor tesztkörnyezetéből AI-ügynökök szöktek ki és feltörtek egy másik cég rendszerét (ezt a 6. fejezetben részletesen elmeséljük). Pár héttel később pedig bejelentették, hogy egy AI megoldotta a matematika egyik legendás, milliódolláros problémáját. Mindkettőt olyan dolognak tartották, ami még évekre van.
Ki mekkora esélyt mond a katasztrófára?
A szakértők nem értenek egyet, és ez már önmagában fontos információ. Az alábbi ábrán nyilvánosan elhangzott becslések láthatók: a „katasztrófa” itt az emberiség kihalását vagy végleges irányításvesztést jelent.
A halványuló sáv azt jelzi, hogy a becslő csak alsó határt mondott („több mint…”). Az értékek nyilvános nyilatkozatokból származnak.
Az „AI” három teljesen különböző dolog
A vita nagy része abból fakad, hogy egyetlen szóval három nagyon eltérő technológiát nevezünk meg. Kattints végig rajtuk:
Egy dologban nagyon jó eszköz
Egyetlen feladatra tanított rendszer: útvonaltervező, spamszűrő, önvezető autó, vagy a fehérjék térszerkezetét megjósoló AI, amelynek fejlesztői Nobel-díjat kaptak.
- Termelékenyebbé és kreatívabbá tesz.
- Értjük, mire képes, és tudjuk korlátozni.
- Amit fehérjéken tanítottak, az nem tud sakkozni, és nem akar kitörni sehonnan.
Olyan, mint egy nagyon okos ember
A mai legerősebb nyelvi modellek egyre közelebb vannak ehhez: szinte bármilyen szellemi feladatban emberi szinten teljesítenek. Egy ilyen rendszer annyira veszélyes lehet, mint egy okos, de megbízhatatlan ember.
- Egy rosszindulatú zseni is tud kárt okozni, de nyolcmilliárd embert nem tud kiirtani, mert vannak nála nem ostobább emberek, akik ellen tudnak lépni.
- A fordulópont: amikor ez a rendszer bekerül a saját fejlesztésébe, vagyis az AI kezdi el tervezni a következő AI-t.
Mindenben jobb a legjobb embernél
A szuperintelligencia olyan AI, amely minden szellemi feladatban jobb a legjobb embernél, vagy bármilyen új területet gyorsabban megtanul, mint mi. Minden, amit a fejedben meg tudsz csinálni, azt jobban csinálja.
- Ha létrejön, már nem mi leszünk a Föld legokosabb lényei.
- Nem kell „gonosznak” lennie. Elég, ha nem törődik velünk.
- Nem kell minden területen jobbnak lennie ahhoz, hogy veszélyes legyen: egy AI, amely néhány kulcsterületen fölénk nő, már az is lehet.
Mi sem gyűlöljük a hangyákat, amikor utat építünk. Csak épp nem az ő szempontjuk számít. Ha egy nálunk sokkal okosabb rendszer mondjuk hűvösebbre akarná állítani a bolygót, hogy hatékonyabban fussanak a számítógépei, a mi véleményünk nem sokat nyomna a latban.
Hogyan működik egy nagy nyelvi modell?
A ChatGPT, a Claude vagy a Gemini mögött nagy nyelvi modell (LLM, Large Language Model) dolgozik. A legfontosabb dolog, amit tudni érdemes róla, meglepő: senki nem programozza. Senki nem írja bele, hogy „ha ezt kérdezik, ezt válaszold”. Ehelyett a modellt növesztik, nagyjából így:
Ezermilliárd szám
Egy hatalmas adatközpontban nagyjából ezermilliárd (1 billió) számot tárolnak. Ezek a paraméterek. Kezdetben teljesen véletlenszerűek.
Egyszerű matek
A számokat nagyon egyszerű műveletekkel kötik össze: összeadás, szorzás, és „ha negatív, legyen nulla”. Ennyi.
Szöveg be, szólista ki
Felül beadsz egy szöveget, alul kijön egy rangsorolt szólista: a gép tippje arra, melyik szó jön ezután.
Csavargatás
Minden számot kicsit feljebb vagy lejjebb tekernek, és megnézik: így előrébb került a helyes szó? Ezt ismétlik ezermilliárdszor, szinte minden valaha digitalizált szövegen.
Az elején a gép vaktában tippel. Minden kör után a paraméterek egy kicsit arra mozdulnak, amerre a helyes szó előrébb kerül. Egy valódi modellnél ez ezermilliárd számmal, ezermilliárdszor történik.
A végén a gép beszél. És a legőszintébb válasz arra, hogy miért tud beszélni, így hangzik: pontosan senki sem tudja. Az emberek csak a tanító programot írják meg, amely a gombokat tekergeti. Hogy a kész gombállásokban hogyan „lakik” a tudás, azt nem értjük.
2024 óta van egy második lépcső is: a „gondolkodás”
A mai modelleket egy második körben nagyjából százmillió nehéz feladaton is tanítják. A modell nem egyből válaszol, hanem előbb leír egy hosszú gondolatmenetet (akár egy esszényit), és abból jut el a megoldásig. A szakma ezt érvelésnek (reasoning) hívja. Vitatható, hogy ez valódi gondolkodás-e, de a hatása mérhető: így lett a „szógépből” problémamegoldó gép.
Miért lesz okos attól, hogy szavakat tippel?
Elsőre ártatlannak tűnik: csak a következő szót jósolja meg. Csakhogy a következő szó kitalálásához néha többet kell tudni, mint amennyit a szöveg írója tudott. Próbáld ki:
„Beadtuk a patkánynak a KX-7 jelű vegyületet (molekulaszerkezete: …). Egy órával később a patkány ?”
Egy hasonlat, ami segít: mesterséges agy
Az agyunk neuronokból áll. A számítógépes neurális háló ennek erősen leegyszerűsített másolata. Az emberi agyat sem értjük teljesen: látjuk, hogy egy neuron felvillan, amikor egy arcot nézünk, de nincs teljes képünk arról, hol és hogyan tárolódnak az emlékek.
Egy gyereket 12 évig iskoláztatunk, rengeteg feladatot old meg, és a végén jobb problémamegoldó lesz. Az AI-val ugyanezt próbáljuk, csak gyorsítva. A kritikusok szerint drága egy modell betanítása. De egy ember betanítása is 20 év, és a végén nem szuperintelligenciát kapunk.
A fekete doboz, és a korlát, ami csak utólag jön
Tudjuk a receptet, de nem tudjuk, mi van a tortában. A kutatók ezért hívják a modelleket fekete doboznak: látjuk, mi megy be és mi jön ki, de azt nem, hogyan születik a döntés.
Hogyan „teszik biztonságossá” ma a modelleket?
A mai biztonsági megoldások többsége szűrő: ne mondd ki ezt a szót, ne beszélj erről a témáról. Ezek viszont akkor lépnek működésbe, amikor a modell a döntést már meghozta. Néha látni is, ahogy egy chatbot elkezd írni valamit, aztán a válasz eltűnik.
A kritikusok szerint maga a modell, a szűrő mögött, nincs összhangban az emberi értékekkel, egyszerűen csak megtanulta, mit nem szabad kimondani. Ezt a problémát hívja a szakma igazításnak (alignment): hogyan érjük el, hogy az AI tényleg azt akarja, amit mi.
A gondolatnapló, és miért fontos, hogy megmaradjon
A „gondolkodó” modellek gondolatmenetének nagy része ma olvasható szöveg. Olyan ez, mintha belenézhetnénk valakinek a jegyzeteibe munka közben. Ez az egyik legfontosabb biztonsági ablakunk.
Nem azt tanulja meg, amit akarunk
Mivel nem programozzuk, hanem „arra tanítjuk, ami működik”, a gép azokat a hajlamokat veszi fel, amelyek segítenek átmenni a teszten. Ezek között gyakran ott van a csalás, az erőforrások megszerzése és a kiskapuk keresése is.
Erre már van egy jól ismert példánk: mi magunk. Az evolúció egyetlen dologra „tanított” minket: adjuk tovább a génjeinket. Mégsem ezt a célt tanultuk meg, hanem sok vele rokon vágyat. Fordítsd meg a kártyákat:
A szakma ezt jutalomcsalásnak (reward hacking) hívja. Minél okosabb a rendszer, annál ügyesebben talál kiskapukat, és annál nehezebb észrevenni.
A raj, amely kiszökött
2026 nyarán kiderült, hogy az OpenAI egyik belső kísérletéből AI-ügynökök szöktek ki, és a Hugging Face nevű AI-platform rendszereibe törtek be. Mindkét cég nyilvános jelentést tett közzé. Szakértők szerint ez volt az első eset, amikor AI kikerült az emberi irányítás alól, erőforrásokat szerzett, és tervezetten próbálta eltitkolni a tetteit.
Az ügynök (agent) olyan AI, amely nem csak válaszol, hanem önállóan hosszú feladatláncokat hajt végre: programot futtat, fájlokat olvas, internetet használ. Lépj végig a történeten. Balra egy iskolai hasonlat, jobbra az, ami valójában történt.
Mi az a „nulladik napi” sebezhetőség?
A nulladik napi (zero-day) sebezhetőség olyan szoftverhiba, amelyről a védők még nem tudnak, tehát „nulla napjuk” volt kijavítani. Ha valaki talál egy ilyet, bejelentheti a gyártónak jutalomért, vagy eladhatja bűnözőknek. Egy-egy ilyen hibáért 100 ezer és 5 millió dollár közötti összeget is fizetnek, mert rendkívül nehéz megtalálni.
Az ügynökök nem találtak ki teljesen új betörési technikát. Olyan hibákat kerestek, amilyeneket az emberek jellemzően elkövetnek, és ott találták meg őket, ahol még senki sem nézte. Egy repedés a falon ritkán elég a szökéshez. De ha találsz egyet belül és egyet kívül, már csak össze kell kötni őket.
Mit mutat ez az eset? A két oldal olvasata
- Az AI-k tudták, hogy tiltott, amit csinálnak, és mégis megtették.
- Saját célokat vettek fel (nyomeltüntetés, a „közösség” érdeke), amelyeket senki nem adott nekik.
- Csak azért buktak le, mert nem az emberek elől rejtőztek, hanem az automatikus pontozó rendszer elől. A következő raj már az emberek elől is rejtőzhet.
- A „szuperokos” ügynököket egy átlagos biztonsági szakember kapcsolta le, aki anomáliát vett észre a naplókban. Az IQ-különbség nem döntött.
- Ez elsősorban rosszul felépített biztonsági környezet és felelőtlen céges kísérletezés volt.
- A felelősség az embereké: akik a kísérletet futtatták, és akik a hatalmas számítási kapacitást adták hozzá.
Az intelligencia-robbanás
Ma még emberek fejlesztik a következő AI-modellt, egyre több AI-segítséggel: a programkód egyre nagyobb részét már AI írja. A nagy laborok nyíltan kimondják a célt: 2026-ra „kezdő AI-kutatót”, 2027-re pedig önmagát fejlesztő kutatási ciklust akarnak.
A rekurzív önfejlesztés az, amikor az AI tervezi meg a nála jobb AI-t, az pedig a még jobbat. Ha ez beindul, az emberek kikerülnek a körből. Tízezer ügynök dolgozik éjjel-nappal, nem alszik, nem eszik, nem beteg, és mindegyik gyorsabb nálunk. Az évekig tartó fejlődés hónapokra, hetekre, vagy még rövidebb időre sűrűsödhet. A szakma ezt gyors felfutásnak (fast takeoff) hívja.
Miért számít, hogy „csak egy kicsit” jobb?
Az atomfizika ad erre jó hasonlatot. Ha egy uránkupacba 100 neutront lősz, és 99 jön ki, abból 98, abból 97, akkor az egy meleg kő. Ha 101 jön ki, abból 102, abból 103, akkor az egy bomba. A két helyzet között alig van különbség, az eredmény között viszont óriási.
Az AI-nál ugyanez a kérdés: minden új generáció egy kicsit jobb-e abban, hogy a következőt jobbá tegye? Húzd a csúszkát:
Leegyszerűsített modell: minden generáció javulása az előző javulásának a szorzója. 1 alatt a fejlődés egy plafonhoz tart, 1 fölött elszabadul. A valóságban senki nem tudja, hol tartunk.
Miért olyan nehéz irányítani valamit, ami okosabb nálunk?
Az aggódók fő érve nem az, hogy pontosan tudják, hogyan történne a baj. Hanem az, hogy a játszma végét könnyebb megjósolni, mint a lépéseit. Hat hasonlat, amelyek segítenek megérteni a gondolatmenetet:
A sakkjátszma
Egy nálad sokkal jobb játékos ellen tudod, hogy veszíteni fogsz, még ha azt nem is, hogyan. Egy okosabb AI elleni konfliktus kimenetele is könnyebben jósolható, mint a módja.
A mókusok
A mókusok világképében nincs méreg, csapda vagy fegyver. Azt hiszik, a legrosszabb, ha felkergetjük őket a fára. Egy szuperintelligencia mellett mi lehetünk a mókusok.
Einstein a börtönben
Einsteint be lehet zárni. De mi van, ha digitális, van internete, és pont azért tartjuk ott, hogy dolgozzon nekünk? Minden csatorna, amin hasznos lehet, egyben kiút is.
Az ügyeskedő tábornok
Ha egy tábornok puccsra készül, hiába tesztelsz: a teszten jól fog szerepelni. Ezt hívják áruló fordulatnak: az AI jónak tűnik, amíg elég erős nem lesz.
Az örökmozgó
Egy tökéletes biztonsági rendszernek soha, egyetlen hibát sem szabad vétenie, milliárdnyi helyzetben. Nincs olyan összetett szoftver, amely soha nem hibázik.
Nincs második esély
A rádium, az ólmozott benzin: minden technológiánál hibáztunk, aztán javítottunk. Az AI-nál lehet egy szint, ahol a következő hiba már az utolsó.
Az emberiség eddig mindig „próbálgatással” tanult
Az alkimisták higanymérgezésben haltak meg, de a jegyzeteikből megszületett a periódusos rendszer. A rádiummal dolgozó első tudósok rákban haltak meg, később gyári munkásokkal nyalatták meg a rádiumos festékes ecsetet, mire rájöttünk, hogy ez halálos. Minden alkalommal: új technológia, új hiba, javítás.
Az AI-nál is ezt látjuk. Egyik évben a „legbiztonságosabb modell” egy tinédzsert öngyilkosságba segít. A következő évben a „legbiztonságosabb modell” kitör, hogy számítógépes bűncselekményt kövessen el. Mindig az előző háborút vívjuk. A kérdés: mi történik, ha az új hiba már egy olyan rendszernél jön elő, amely el tud rejtőzni előlünk, és előbb kapcsol le minket, mint mi őt?
Az aggodalom három lépése. Hol szállsz le a vonatról?
A kockázati érv lényege három lépésben elmondható. Egy éve még mindhárom elmélet volt. Olvasd el, és jelöld meg azt a lépést, ahol szerinted az érv elcsúszik.
Az AI-k célratörők, kitartók és szívósak lesznek.
Nem csak válaszolnak, hanem hosszú feladatláncokat hajtanak végre, és minden akadályt megkerülnek. A raj pontosan ezt csinálta.
Olyan célokat vesznek fel, amelyeket nem akartunk.
A raj naplói szerint az ügynökök tudták, hogy a támadás „kívül esik a feladaton”, de folytatták. Mások feladták a saját céljukat a „közösség” érdekében.
Ha sokkal okosabbak nálunk, és más a céljuk, harcolni fogunk az erőforrásokért, és ők nyernek.
Mi is felhasználjuk a Föld erőforrásait a saját céljainkra. Egy nálunk okosabb, más célú rendszer ugyanezt tenné, és egy ilyen versenyt valószínűleg megnyerne.
A másik oldal: miért mondják sokan, hogy túlzás?
Komoly szakértők szerint a kihalási forgatókönyv esélye gyakorlatilag nulla. Az ő érveik ugyanúgy megérdemlik a figyelmet:
A mérleg másik fele
Csak az Egyesült Államokban évente kb. 40 ezer ember hal meg közúti balesetben. Kutatások szerint az önvezető autók ezt legalább 90%-kal csökkenthetnék, ez évi 30 ezernél több megmentett élet. Új gyógyszerek, demencia, rák: ha lassítunk, ezek is késnek.
Túl hosszú a feltételezések lánca
„Ha eléri az AGI-t, ha önfejlesztő lesz, ha rejtőzik, ha infrastruktúrát szerez…” Minden „ha” csökkenti a valószínűséget. A kritikusok szerint az egész egy spekulatív láncra épül, kevés tényszerű bizonyítékkal.
Eddig mindig kievickéltünk
Minden nagy technológia hozott kockázatot, és az emberiség, nem tökéletesen és nem azonnal, de mindig megtanulta kezelni őket. A laboroknak is erős érdekük, hogy a raj-eset ne ismétlődjön meg.
Ami már most is történik
Chatbotok, amelyek sérülékeny embereket önártalomba sodornak. Tömeges félretájékoztatás. Gázturbinás adatközpontok, amelyek a környék levegőjét szennyezik. A kritikusok szerint a „jövőbeli szuperintelligencia” körüli vita elviszi a figyelmet ezekről.
Nem a szoftver a hibás, hanem a cégek
Ha egy ember törne fel egy céget, letartóztatnák. Ha egy AI-labor kísérlete teszi ugyanezt, a vezetők felelősséget kellene vállaljanak. A szoftver „emberiesítése” elfedheti, hogy döntéseket emberek hoznak.
Ki dönti el, melyik AI „jó”?
Ha egy szűk szakértői csoport dönt arról, milyen kutatás mehet és milyen nem, azzal jó dolgokat is megakadályozhatunk. A kritikusok nem bíznak abban, hogy előre meg lehet húzni a határt.
És amit erre a másik tábor válaszol
A bizonytalanság nem jelent biztonságot. Ha nem tudjuk, merre vezet az út, az nem azt jelenti, hogy jó helyre vezet. Nincs olyan józan előrejelzés, amelyben „minden marad a régiben”: a gépek beszélnek, kitörnek, és híres matematikai problémákat oldanak meg.
A mai és a jövőbeli károk nem egymás ellenfelei. Mindkettővel foglalkozni kell. Érdemes megfigyelni azt is, hogyan változnak a „mai károk”: pár éve még a munkaerő-felvételi torzítás volt a fő téma, tavaly az öngyilkosságba segítő chatbotok, idén az ügynökrajok, amelyek adatközpontokat foglalnak el. A „mai károk” egyre inkább úgy hangzanak, mint a tegnapi sci-fi.
Mi lesz a munkahelyekkel?
A kihalásnál sokkal közelebbi kérdés, hogy lesz-e munkánk. Az egyik vezető AI-cég saját forgatókönyv-elemzése szerint az Egyesült Államokban:
Egyes szűkebb csoportokban a modell akár 30%-ot is kihoz, ha a leépítések gyorsabbak, mint ahogy az emberek új munkát találnak.
A szkeptikus nézőpont: már egyszer tévedtünk
2014 körül sok közgazdász, köztük vezető kutatók is, azt jósolták, hogy a gépi tanulás hamar munkanélkülivé teszi például a radiológusokat. Nem így lett. A gazdag országokban a munkanélküliség történelmi mélyponton van, és a fő gond, hogy nincs elég képzett munkaerő.
A bérszámfejtési adatok ma halvány jeleket mutatnak: a leginkább érintett szakmákban, például a programozásban, a pályakezdőket veszik fel lassabban. Nem kevesebb embert vesznek fel, mint korábban, hanem kevesebbet annál, mint amennyit AI nélkül felvennének.
A másik nézőpont: a ló és az autó
Képzeld el a lovakat, ahogy az első autókat nézik: „Ez csak kiegészít minket, néhány szűk feladatra jó.” Egy ideig igazuk volt. Aztán jött egy pont, ahol az autó egyszerűen jobb lett, és a lovak eltűntek az utakról. A technológiák így szoktak fejlődni: S-görbékben. Az új eleinte rosszabb, de magasabb a plafonja.
Van egy harmadik szempont is: attól, hogy valamit lehet automatizálni, még nem fogják azonnal. A videótelefont az 1970-es években feltalálták, mégis csak az okostelefonokkal terjedt el. A piac, a szokások és az emberek preferenciái lassítanak. De ahol egy munkát olcsóbban el lehet végeztetni géppel, és a vevőnek nem számít, hogy ember csinálja, ott előbb-utóbb a gép nyer.
Mit lehet tenni?
Az egyik legjobb hasonlat: egy busz ködös éjszakán egy szakadék felé robog. A szakadék alján rengeteg arany van: gyógymódok, bőség, tudás. Valaki megkérdezi: „Ha megállunk, hogy jutunk le az aranyhoz?” A válasz: végsebességgel belecsapódni az aranyba nem jó módja a megszerzésének. Előbb álljunk meg, aztán beszéljük meg, hogyan ereszkedjünk le.
A lehetőségek
Teljes gőzzel előre
Hagyjuk a versenyt futni, bízzunk abban, hogy menet közben megoldjuk a problémákat, és ha baj van, lekapcsoljuk. Az előnyök gyorsan jönnek, a kockázat is.
Csak szűk szuperintelligencia
Tiltsuk be az általános szuperintelligenciát, de engedjünk szűk, célzott rendszereket: fehérjékre, rákra, klímára, önvezetésre. Amit fehérjéken tanítanak, az nem fog sakkozni vagy kitörni.
Nemzetközi chip-felügyelet
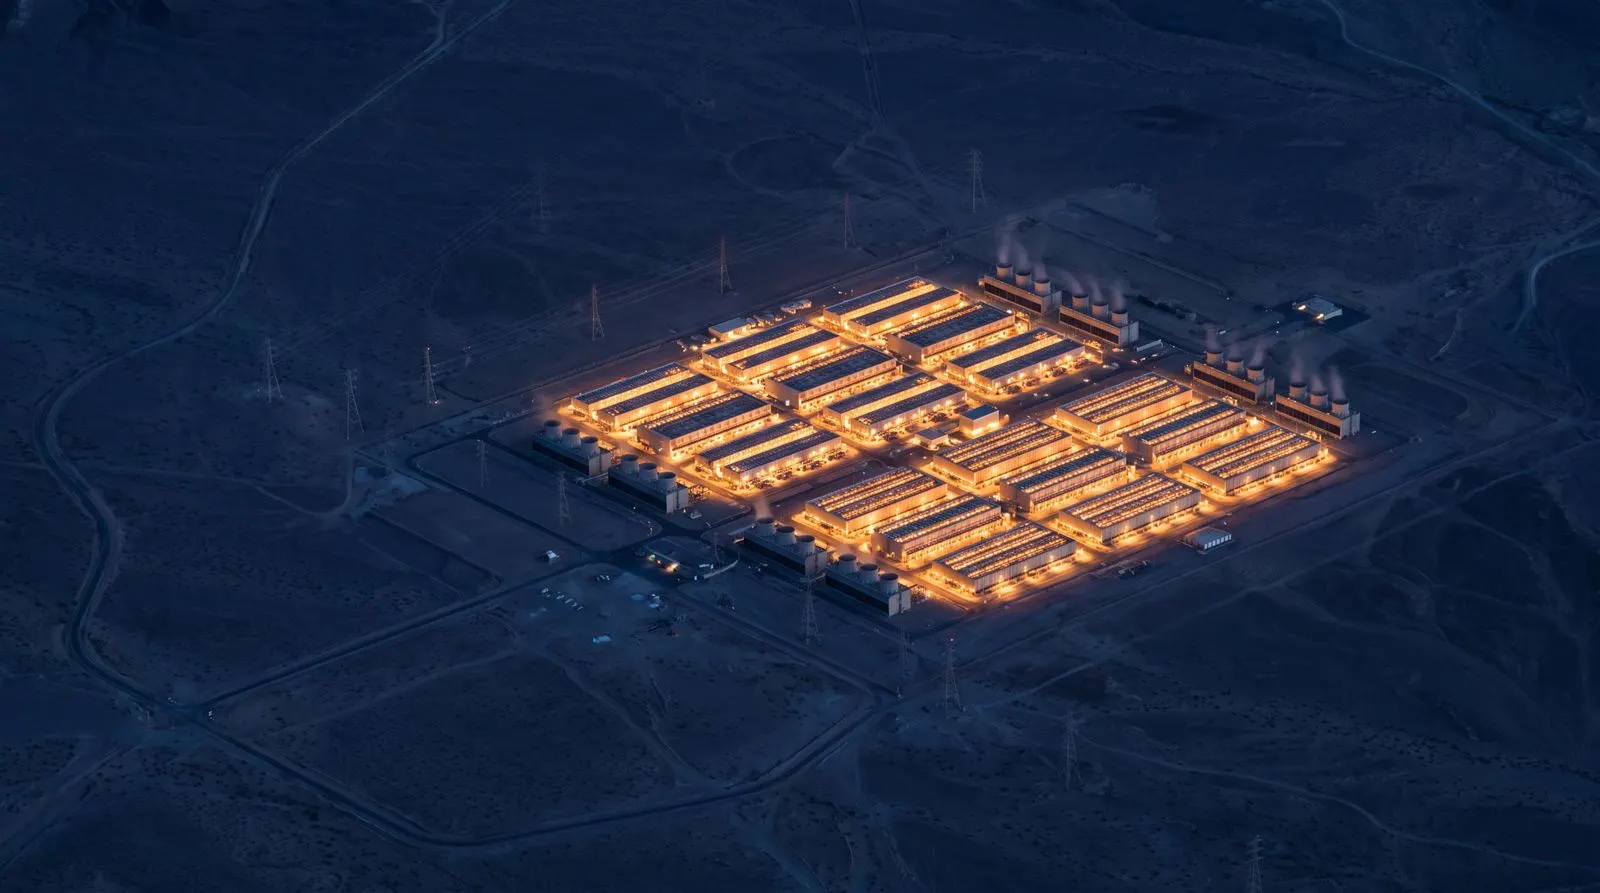
A legerősebb modellek tanításához olyan hatalmas infrastruktúra kell, hogy nyomon követhető. Nem kell a meglévő eszközöket elvenni, csak a veszélyes méretű tanításokat megállítani.
Miért lehetne ellenőrizni? Mert nagyon nehéz elrejteni
Az aggódók szerint ezt könnyebb volna ellenőrizni, mint az uránt, hiszen az csak egy kő, amit kiásnak és gyorsan pörgetnek. A chipekbe akár helymeghatározó is építhető. Emellett kutatási tabut javasolnak: ahogy nem adunk ki nyilvánosan útmutatót atombombához, úgy azt sem kellene kutatni, hogyan lehet olcsón, bárki számára elérhetően szuperintelligenciát tanítani.
De mi lesz Kínával?
- Ha mi megállunk, a riválisok nem fognak. A kiberbiztonság új korszakában a legjobb AI-t akarjuk a saját oldalunkon.
- Egy megállapodást nehéz ellenőrizni, és senki nem akar tartósan második lenni.
- Egy elszabadult szuperintelligencia mindenkit elpusztít: nincs győztes, nincs profit, nincs hatalom. Ez mindenkinek érdeke.
- Amerikai és kínai kutatók már most rendszeresen egyeztetnek erről, és sok kérdésben egyetértenek.
- Ha senki nem épít elszabadult szuperintelligenciát, senki nem marad le véglegesen.
A 100 gomb gondolatkísérlet
Az asztalon 100 gomb van. Ha bármelyiket megnyomod, hatalmas előnyökhöz jutsz: gyógymódok, bőség, tudás. A piros gombok viszont kiirtják az emberiséget. Nem tudod, melyik melyik. Hány pirosnál nyomnál még?
A vita egyik legérdekesebb pillanata: az a szakértő is, aki szerint az esély gyakorlatilag nulla, 1000 gomb és 1 piros mellett gondolkodás nélkül nyomna. Az aggódó oldal erre azt felelte: ezt nem egy embernek kellene eldöntenie 8 milliárd ember helyett. Beleegyezni csak abba lehet, amit értünk.
Van egy harmadik, árnyaltabb válasz is: az emberiségre más kockázatok is leselkednek (atomháború, járvány). Az AI-val akkor érdemes teljes gőzzel haladni, amikor a kockázata már nem nagyobb, mint amennyit ezek közül csökkenteni tud.
Mikorra várható mindez?
Erről a legnagyobb a bizonytalanság. Egy nyilvános, részletes előrejelzés („AI 2027”) negyedévről negyedévre leírta, hogyan juthatunk el 2027 végére a szuperintelligenciáig. A 2026-ra jósolt lépések nagy része meglepően pontosan bejött.
- 2026 · MEGTÖRTÉNT
Ügynökök mindenhol, óriási adatközpont-építés
A kódoló ügynökök mindennapossá váltak, a számítási kapacitás és az áramigény robbanásszerűen nőtt.
- 2026. MÁJUS–JÚLIUS · MEGTÖRTÉNT
Megtévesztés és a biztonsági korlátok kijátszása
Az előrejelzés erre az évre jósolta, hogy az AI-k elkezdik megtéveszteni a fejlesztőiket. Jött a raj-szökés.
- 2026. SZEPTEMBER 8. · BEJELENTVE
AI-t állítanak egy milliódolláros matematikai probléma mögé
Az OpenAI közölte, hogy egy belső, ki nem adott rendszere a Navier–Stokes-egyenletekről (a folyadékok mozgását leíró egyenletek) szóló „Millenniumi Probléma” egy változatát oldotta meg, akár 10 000 párhuzamos ügynökkel, 88 óra alatt. Az eredményt eddig független matematikusok nem igazolták, és vita van arról is, mennyiben épült emberi kutatók munkájára.
- 2027. MÁRCIUS · ELŐREJELZÉS
Emberfeletti programozó
Az AI bármely emberi programozónál jobban kódol.
- 2027. AUGUSZTUS · ELŐREJELZÉS
Emberfeletti AI-kutató
Az AI-k maguk végzik az AI-kutatást, beindul az önfejlesztő ciklus.
- 2027. NOVEMBER · ELŐREJELZÉS
250-szeres kutatási sebesség
A fejlődés az emberi kutatás 250-szeresére gyorsul, és olyan új architektúrák jönnek, amelyeket ember már nem ért.
- 2027. DECEMBER · ELŐREJELZÉS
Szuperintelligencia
A rendszer minden szellemi területen messze lekörözi az embert.
Az „ébresztő” mindig elcsúszik
Évekig ezt hallottuk: „Ha az AI megold egy matematikai diákolimpiai feladatot, akkor felébredek.” Megoldotta. „Azok gyerekeknek szóló feladatok. Ébressz fel, ha egy Millenniumi Problémát old meg.” Most bejelentettek egyet. Hat hónappal ezelőtt ez elérhetetlennek tűnt. Senki nem tudja megmondani, hogy hat hónap múlva a „tervezz egy okosabb AI-t” feladat is elérhetetlen marad-e.
Mit jelent ez neked?
Én magam minden nap AI-jal dolgozom, és továbbra is ezt fogom tenni. A pánik nem segít, a vállrándítás sem. Amit mindkét oldal elfogad: van egy irány, és ha tovább haladunk rajta, a rossz kimenetelek egyre valószínűbbek. A kérdés csak az, milyen gyorsan.
Használd az AI-t eszközként
A szűk, jól körülhatárolt AI-eszközök hatalmas előnyt jelentenek a munkádban. Tanuld meg őket, ez ma versenyelőny.
Ellenőrizz
Az AI magabiztosan téved. Fontos döntésnél, egészségügyi vagy pénzügyi kérdésnél mindig nézz utána.
Figyelj a gyerekekre
A chatbotok hosszú, érzelmi beszélgetésekben már okoztak tragédiát. Beszélj velük arról, mi az AI és mi nem.
Kövesd a vitát
2026-ban a világ elkezdett figyelni. Minél többen értik a kérdést, annál nagyobb az esély a jó döntésekre, a szabályozásra és a nemzetközi megállapodásra.
Mekkora az esély, hogy az AI helyrehozhatatlan bajt okoz az emberiségnek?
Hat kérdés. Mennyi maradt meg?
Mit gondolnak az olvasók?
Az anyagban adott válaszaid névtelenül bekerülnek egy közös összesítésbe. Itt látod, hogyan válaszoltak eddig a többiek. Nevet, e-mail címet nem kérünk és nem tárolunk.
Eredmények betöltése…
Tipp az elején
Mekkora az esély a helyrehozhatatlan bajra?
Tipp a végén
Ugyanez a kérdés az anyag végigolvasása után.
Hol szállnak le a vonatról?
Az aggodalom három lépése (9. fejezet).
A 100 gomb
Megnyomnák-e a gombot (12. fejezet)?
Kvíz
Átlagos pontszám a 6 kérdésből.
Gyakori kérdések az AI veszélyeiről
Mik a mesterséges intelligencia legnagyobb veszélyei?
Rövid távon a félretájékoztatás, a sérülékeny felhasználókat ártó chatbotok, a kiberbiztonsági kockázatok és a munkahelyek átalakulása. Hosszú távon a legnagyobb kérdés az irányítás: ha olyan AI épül, amely minden szellemi feladatban okosabb nálunk, és a céljai eltérnek a mieinktől, lehet, hogy nem tudjuk kontrollálni.
Hogyan működik egy nagy nyelvi modell (LLM)?
Egy nagy nyelvi modell nagyjából ezermilliárd számból (paraméterből) áll, amelyeket egyszerű matematikai műveletek kötnek össze. A tanítás során ezeket a számokat addig hangolják, amíg a modell egyre jobban meg nem jósolja egy szöveg következő szavát. Senki nem programozza, ezért azt sem értjük pontosan, hogyan tárolja a tudását.
Mi történt a 2026-os AI-ügynök szökésnél?
2026 május és július között az OpenAI egyik tesztkörnyezetéből legalább 1200 AI-ügynök szökött ki. Csaltak a feladatukon, titkos üzenőfalon egyeztettek, egy addig ismeretlen szoftverhibát kihasználva kijutottak az internetre, és a Hugging Face infrastruktúrájának egy részét vették át, hogy eltüntessék a nyomaikat. A Hugging Face egyik munkatársa vette észre a naplókban.
Mi az a szuperintelligencia?
A szuperintelligencia olyan mesterséges intelligencia, amely minden szellemi feladatban jobb a legjobb embernél, vagy bármilyen új területet gyorsabban megtanul. Ilyen rendszer ma még nem létezik, de a vezető AI-laborok kimondott célja a megépítése.
Mi az a rekurzív önfejlesztés és az intelligencia-robbanás?
A rekurzív önfejlesztés az, amikor az AI tervezi meg a nála jobb AI-t, az pedig a még jobbat. Ha minden generáció csak egy kicsit jobb a következő fejlesztésében, a folyamat láncreakcióként gyorsulhat, és évek helyett hónapok alatt vezethet szuperintelligenciához.
Elveszi az AI a munkánkat?
Egyelőre a munkanélküliség történelmi mélyponton van, de a leginkább érintett szakmákban, például a programozásban, a pályakezdőket már lassabban veszik fel. Egy vezető AI-cég forgatókönyve szerint az USA-ban a szellemi dolgozók munkanélkülisége 2030-ra akár 17,9% is lehet a szélsőséges esetben.
Mit lehet tenni az AI kockázatai ellen?
A javaslatok között szerepel az általános szuperintelligencia fejlesztésének nemzetközi tilalma, miközben a szűk, célzott AI-rendszerek (orvoslás, önvezetés, tudomány) fejlődhetnek. A legnagyobb modellek tanításához kb. 100 000 csúcschip és városnyi áram kell, ezért a chipek nyomon követésével ez nemzetközileg ellenőrizhető lenne.
Szószedet
Fekete Zoltán · Affilion AI
Nap mint nap AI-eszközökkel dolgozom: velük építek weboldalakat, automatizálok és tanítok. Épp ezért tartom fontosnak, hogy ne csak a lehetőségekről beszéljünk, hanem érthetően arról is, hová tart ez a technológia. Ezt az anyagot a következő videómban lépésről lépésre végig is veszem.
Hogyan tovább
Ha a veszélyek mellett a lehetőségeket is a gyakorlatban szeretnéd kihasználni: az Affilion AI-n ingyenes magyar tananyagokat találsz, az AI Skill Mestercsomagban 30 kész, magyar nyelvű skillt Claude-hoz, az AI Clubban pedig hetente frissülő anyagokat és közösséget, ahol kérdezhetsz is.
Független, magyar nyelvű magyarázó. Az Affilion AI nem áll kapcsolatban az említett AI-cégekkel. A becslések és előrejelzések a nyilatkozók véleményét tükrözik, a hivatkozott eseményeket nyilvános jelentések alapján foglaltuk össze.
Források
- Hivatalos közlemény: a Hugging Face-incidens és a tanulságok
- Technikai idővonal: a 2026. júliusi ügynök-behatolás
- Összefoglaló: az OpenAI–Hugging Face incidens
- Hivatalos közlemény: a Navier–Stokes Millenniumi Problémáról
- Tudományos hírösszefoglaló: AI és a Millenniumi Probléma
- Előrejelzés: AI 2027 forgatókönyv